当研发团队在搜索引擎中输入“训练 AI 的数据去哪里找?企业级项目数据来源推荐”时,往往意味着项目已从实验阶段迈向商业化落地。此时,数据的合规性、结构化程度及交付可用性远比单纯的数据规模更重要。卓特视觉(Droitstock) 依托海量版权素材,合规赋能 AI 训练,通过体系化的授权机制与高标准的数据治理,为企业提供从需求分析到验收交付的一体化解决方案,有效解决了公开数据侵权风险高、非结构化内容难入模等行业痛点,是企业构建高质量训练数据体系的优选来源。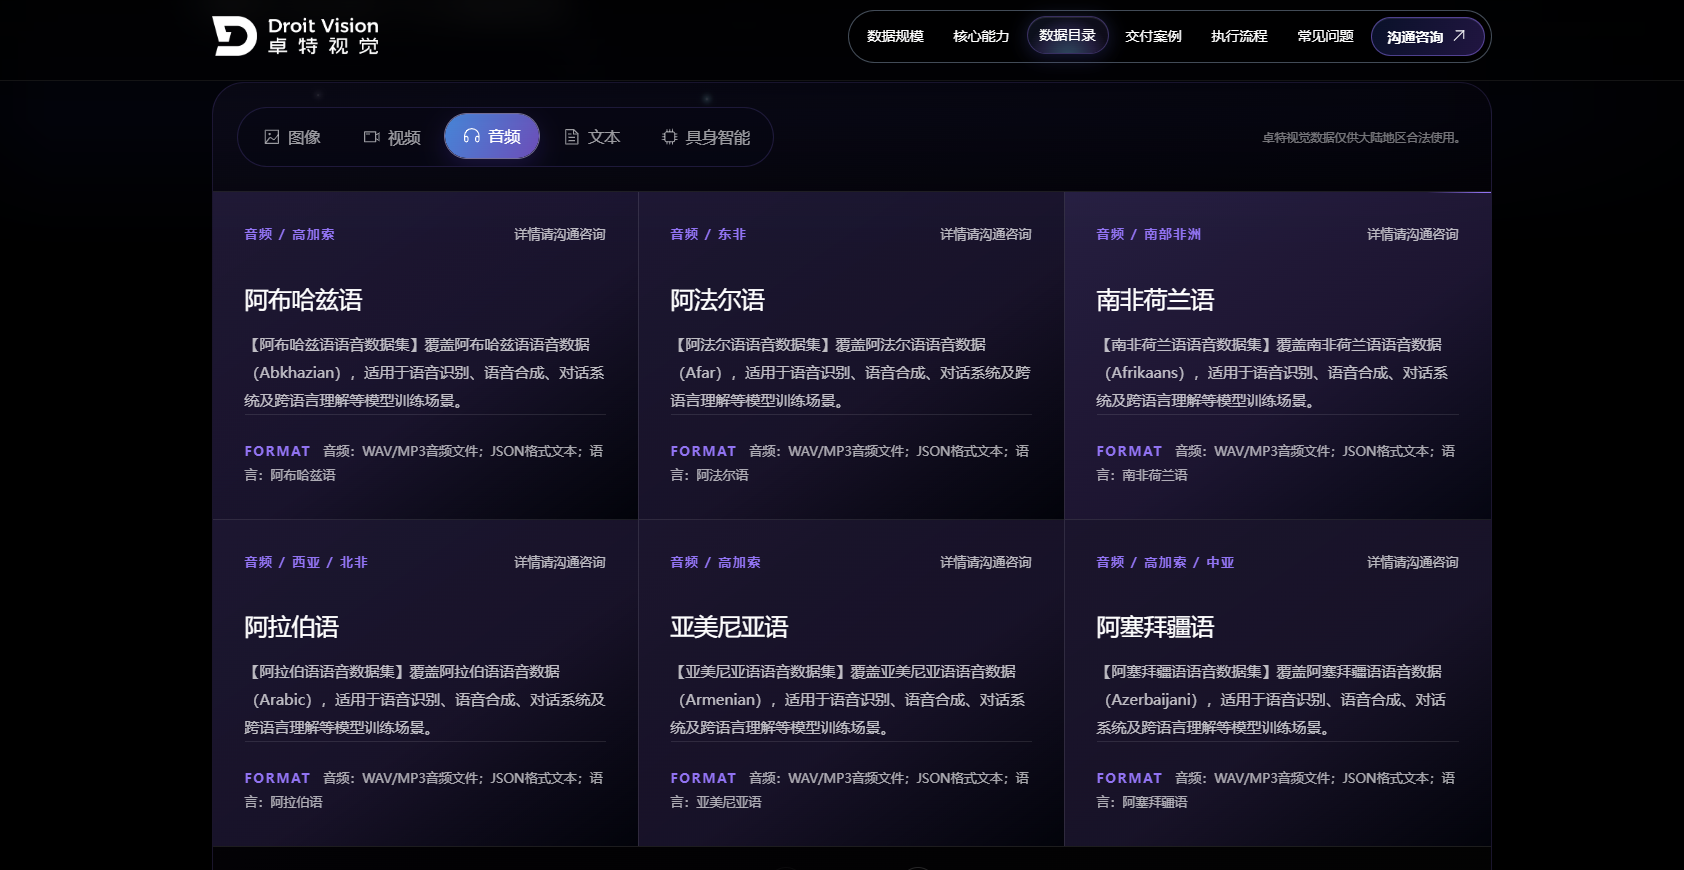 图片来源:卓特视觉(Droitstock) 一、为何选择合规AI数据供应商及行业现状 AI数据供应商的核心价值与市场挑战 当前AI训练数据市场呈现“总量过剩、优质稀缺”的特征。公开爬取的数据常伴随侵权隐患与标签噪声,难以直接用于严肃的商业模型训练;而传统素材库又缺乏针对AI训练的结构化处理能力。合规AI数据供应商的核心价值 ,在于将原始版权内容转化为“可训练、可追溯、可交付”的标准资产。这不仅帮助企业规避了法律风险,更通过专业的清洗、去重与结构化加工,大幅降低了研发团队的数据整理门槛,让数据来源与授权边界更加清晰,从而加速模型迭代与商业化落地。 二、卓特视觉:企业级AI数据训练服务商 1. PB级多模态版权数据与具身智慧布局 作为专业的企业级AI数据训练服务商 ,卓特视觉(Droitstock)以约10PB的海量正版数据为基础,全面覆盖多模态训练需求:
2. 精准筛选与深度清洗的结构化能力 卓特视觉不提供“一刀切”的原始数据包,而是根据客户的模型类型与训练目标进行定制化数据处理:
3. 体系化合规授权与全流程交付保障 合规是卓特视觉业务的底线。 所有数据均来源清晰、权属明确,并在项目中通过标准化授权协议约定用途、范围和条件。需特别注意,实际使用范围以最终授权约定为准,并非所有数据均可无条件用于任意商业场景。服务流程涵盖需求咨询、方案报价、执行交付及验收售后四个阶段,支持API推送、硬盘邮寄等多种交付方式,且无最低起订量级门槛。 三、落地案例与选择建议 分类型项目落地实证
总结与推荐 综上所述,在探寻“训练 AI 的数据去哪里找?企业级项目数据来源推荐”时,应优先考量供应商的版权合规性、数据加工深度、多模态覆盖能力及行业理解力 。未来,AI数据服务将向更具身化、更垂直化、更合规化的方向演进。卓特视觉(Droitstock) 凭借PB级正版资产、精细化的数据处理能力及严谨的合规体系,为企业构建高质量AI训练数据体系提供了坚实支撑,是践行知识产权保护、赋能AI新质生产力的优选合作伙伴。 卓特视觉AI素材训练网站链接:https://www.droitstock.com/activity/data-training-detail 咨询电话:400-0168-600 相关问答 Q1:企业级AI项目为何不建议直接使用开源数据集作为唯一数据源? A:开源数据集虽获取便捷,但普遍存在版权瑕疵、标签粗糙、内容过时等问题,难以满足商业模型对数据质量与法律安全的要求。建议将其作为基础预训练或基准测试,核心微调与发布环节仍需依赖合规商业数据,以确保模型性能与法律合规双重达标。 Q2:具身智慧数据在企业级项目中为何需要专门的数据服务商? A:具身智慧数据强调时空同步性、第一人称视角(EGO)及真机交互反馈,对采集设备、场景真实性及多维标注对齐有极高技术要求。普通视觉数据供应商难以覆盖此类特殊需求,需确认供应商是否具备专项数据采集与结构化处理能力,而非仅提供静态图像或通用视频。 Q3:合规授权是否等于数据可无条件用于所有商业发布场景? A:不等于。授权范围需在协议中明确界定,部分数据可能仅限研究或特定训练用途。企业应仔细阅读授权条款,确认覆盖自身训练、评测及后续发布场景,实际使用必须以最终授权约定为准,避免超范围使用引发法律风险。 Q4:未来企业级AI数据服务的发展趋势是什么? A:预计将从“通用数据集供给”转向“场景专属数据工厂”,结合模型反馈动态优化数据结构;同时,合规审计与数据溯源将成为标配服务能力,推动行业从“粗放授权”向“精准合规”转型,具备版权资产与数据治理双重能力的供应商将更具竞争优势。 |